16. September 2026
Wie ein kleines Python-Skript entstand, das für neue WordPress-Beiträge automatisch den Vorschau-Tag samt Miniaturbild erzeugt – per Vibe-Coding statt Handarbeit.
Für die Startseite meines Blogs brauche ich zu jedem neuen Beitrag einen kleinen HTML-Tabellen-Tag mit Titel, Datum, Teasertext und einem Vorschaubildchen. Das Skript nimmt mir inzwischen die komplette Arbeit ab: Es erzeugt den HTML-Schnipsel für den Vorschau-Tag, baut daraus automatisch das passende Vorschaubild, bindet es automatisch mit ein und setzt den fertigen Tag am Ende ganz von selbst an der richtigen Stelle auf der Hauptseite meines WordPress-Blogs ein. Entstanden ist das Ganze schrittweise, in drei Ausbaustufen.
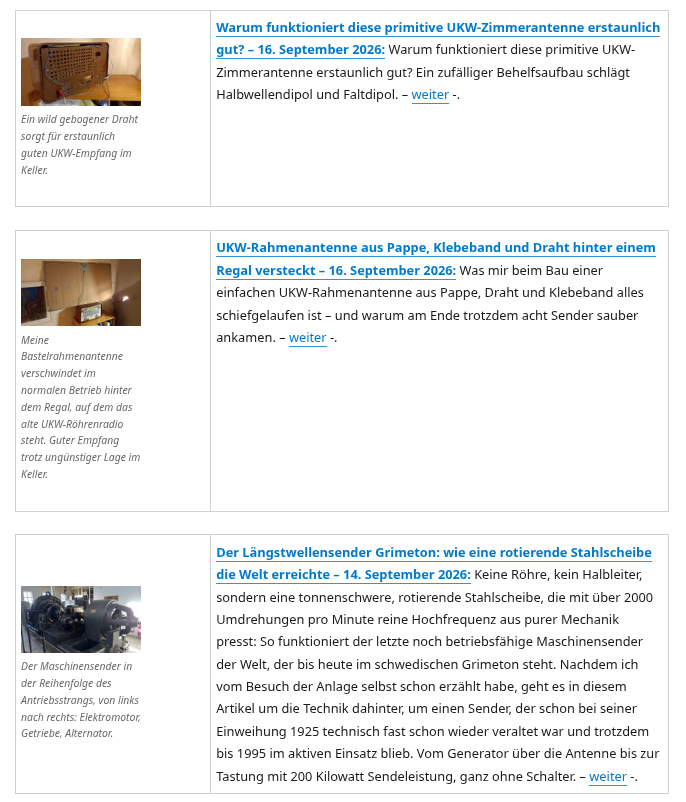
Erste Version – alles noch Handarbeit: Am Anfang stand ein Python-Programm, dem man einfach die URL eines neuen Beitrags übergibt. Es liest Titel, Veröffentlichungsdatum und den ersten längeren Absatz als Teasertext aus, erkennt das erste tatsächliche Bild im Beitrag und erzeugt daraus eine 150 Pixel breite Miniatur mit erhaltenem Seitenverhältnis. Der fertige HTML-Tag lag danach zum Kopieren bereit, doch das Miniaturbild musste ich noch von Hand in die WordPress-Mediathek hochladen und die dortige Bild-URL sowie die Attachment-ID händisch in zwei Platzhaltern im Tag ergänzen.
Zweite Version – das Vorschaubild fügt sich automatisch ein: Diesen Handarbeitsschritt wollte ich los. Also bekam das Skript die Fähigkeit, das erzeugte Miniaturbild eigenständig über die Programmierschnittstelle von WordPress in die Mediathek hochzuladen und die zurückgelieferte Bild-URL sowie Attachment-ID direkt in den fertigen Tag einzusetzen. Übrig blieb nur noch ein einziger Handgriff: den fertigen Tag selbst an der richtigen Stelle auf der Startseite einzufügen.
Dritte und finale Version – der Tag landet automatisch an der richtigen Stelle: Im letzten Schritt fiel auch dieser letzte Handgriff weg. Das Skript lädt jetzt den bestehenden Inhalt der Startseite über die WordPress-Schnittstelle, legt vorher sicherheitshalber eine lokale Sicherungskopie an, sucht die richtige Einfügestelle direkt nach der Überschrift „Die neuesten Beiträge“ und setzt den neuen Tag genau davor. Vor dem eigentlichen Schreiben zeigt es mir eine Vorschau der Stelle und fragt von sich aus nach, ob wirklich veröffentlicht werden soll.
Wie der Zugriff auf WordPress funktioniert: Damit das Skript überhaupt automatisch auf die Mediathek und die Startseite zugreifen darf, braucht es eigene Zugangsdaten. Diese werden einmalig über einen kurzen Einrichtungsdialog im Programm abgefragt und in einer kleinen Konfigurationsdatei im eigenen Benutzerverzeichnis abgelegt, versteckt und nur für mich selbst lesbar. Darin stehen lediglich zwei Angaben: der WordPress-Benutzername und ein sogenanntes Anwendungspasswort. Dieses Anwendungspasswort ist ausdrücklich nicht das normale Login-Passwort, mit dem ich mich ins WordPress-Backend einlogge, sondern ein separates, eigens dafür erzeugtes Passwort, das man im WordPress-Backend unter dem eigenen Benutzerprofil im Bereich für Anwendungspasswörter anlegt. Dort vergibt man einen Namen für die Anwendung, etwa „vorschau-tag-generator“, lässt sich ein neues Passwort erzeugen und trägt es sofort in den Einrichtungsdialog des Skripts ein, denn es wird von WordPress aus Sicherheitsgründen nur ein einziges Mal angezeigt. Mit Benutzername und diesem Anwendungspasswort meldet sich das Skript anschließend bei jedem Aufruf automatisch bei der Programmierschnittstelle von WordPress an, ganz ohne dass ich mich selbst noch einmal einloggen müsste.
Installation und Aufruf: Für den Betrieb braucht es einmalig pip3 install –user requests beautifulsoup4 pillow, danach reicht der Aufruf python3 vorschau_tag_generator.py mit anschließender Eingabe der Beitrags-URL, oder direkt python3 vorschau_tag_generator.py https://elektronikbasteln.pl7.de/dein-beitrag mit der URL als Argument. Die erzeugte Miniatur landet unter ~/Vorschau-Tags/, der fertige Tag liegt dort zusätzlich als Datei und wird gleichzeitig in der Konsole ausgegeben, sodass man ihn direkt kopieren kann.
Das endgültige Skript von Claude.ai erstellt:
#!/usr/bin/env python3
"""
Vorschau-Tag-Generator für Volkers WordPress-Blog (elektronikbasteln.pl7.de)

Erzeugt automatisch den HTML-Vorschau-Tag (Tabelle mit Miniaturbild und
Teaser-Text), wie er auf der Startseite für neue Beiträge eingesetzt wird -
inklusive automatisch erzeugtem Miniaturbild aus dem ersten Bild des Beitrags.

Wenn Zugangsdaten hinterlegt sind (siehe --setup):
  - lädt das Programm das Miniaturbild automatisch in die WordPress-Mediathek
    hoch und setzt die echte Bild-URL und Attachment-ID direkt in den Tag ein.
  - fragt danach von sich aus nach, ob der fertige Tag zusätzlich automatisch
    auf der Startseite eingefügt werden soll, direkt nach "Die neuesten
    Beiträge:" und vor der bisher ersten Tabelle. Vor jeder Änderung wird der
    bisherige Seiteninhalt lokal als Sicherungskopie abgelegt, und es wird
    eine Vorschau sowie eine Bestätigung angezeigt, bevor live geschrieben
    wird. Mit --publish oder --yes lässt sich diese Nachfrage überspringen.

Ohne Zugangsdaten wird das Miniaturbild nur lokal erzeugt, mit Platzhaltern
im Tag zum manuellen Nachtragen.

Verwendung:
    python3 vorschau_tag_generator.py <URL-des-Beitrags>
    python3 vorschau_tag_generator.py <URL-des-Beitrags> --yes

Einmalige Einrichtung des automatischen Uploads/Einfügens:
    python3 vorschau_tag_generator.py --setup

Ohne Argument fragt das Programm interaktiv nach der URL.
"""

import argparse
import base64
import configparser
import re
import sys
import unicodedata
from datetime import datetime
from pathlib import Path
from urllib.parse import urljoin, urlparse

import requests
from bs4 import BeautifulSoup

try:
    from PIL import Image
except ImportError:
    print("Das Modul 'Pillow' fehlt. Installiere es mit:\n    sudo apt install python3-pil")
    sys.exit(1)


# ---------------------------------------------------------------------------
# Konfiguration
# ---------------------------------------------------------------------------

CONFIG_PATH = Path.home() / ".vorschau_tag_generator.ini"
OUTPUT_DIR = Path.home() / "Vorschau-Tags"
BACKUP_DIR = OUTPUT_DIR / "Backups"

MONATE = [
    "Januar", "Februar", "März", "April", "Mai", "Juni",
    "Juli", "August", "September", "Oktober", "November", "Dezember",
]

TABLE_STYLE = 'style="width: 97.381%;"'
LEFT_CELL_STYLE = 'style="width: 29.0412%;"'
RIGHT_CELL_STYLE = 'style="width: 68.2207%; text-align: left; vertical-align: top;"'
TABLE_OPEN_TAG = f"<table {TABLE_STYLE}>"
FRONTPAGE_MARKER = "Die neuesten Beiträge:"
DEFAULT_PAGE_ID = 93
THUMB_WIDTH = 150
USER_AGENT = "Mozilla/5.0 (VorschauTagGenerator/1.0)"

# Platzhalter für den Fall, dass kein automatischer Upload eingerichtet ist
PLATZHALTER_ID = "HIER-ID-EINTRAGEN"
PLATZHALTER_URL = "HIER-BILD-URL-NACH-UPLOAD-EINTRAGEN"


def load_config():
    cfg = configparser.ConfigParser()
    if CONFIG_PATH.exists():
        cfg.read(CONFIG_PATH)
    if "wordpress" not in cfg:
        cfg["wordpress"] = {}
    return cfg


def save_config(cfg):
    with open(CONFIG_PATH, "w") as f:
        cfg.write(f)
    CONFIG_PATH.chmod(0o600)


def setup_wizard():
    print("Einrichtung des automatischen Bild-Uploads und Seiten-Einfügens.\n")
    print("Dafür brauchst du ein 'Anwendungspasswort' (nicht dein normales Login-Passwort):")
    print("  WordPress-Backend -> Benutzer -> Profil -> Anwendungspasswörter")
    print("  Namen vergeben (z.B. 'vorschau-tag-generator'), erzeugen lassen,")
    print("  das angezeigte Passwort hier gleich einfügen (wird nur einmal angezeigt).\n")
    user = input("WordPress-Benutzername: ").strip()
    if not user:
        print("Abgebrochen. Es wurde nichts gespeichert.")
        return
    app_password = input("Anwendungspasswort: ").strip()
    cfg = load_config()
    cfg["wordpress"]["user"] = user
    cfg["wordpress"]["app_password"] = app_password
    save_config(cfg)
    print(f"\nGespeichert in {CONFIG_PATH} (nur für dich lesbar).")
    print("Ab jetzt lädt das Programm Miniaturbilder automatisch hoch.")
    print("Mit --publish kann es den Tag zusätzlich auf der Startseite einfügen.")


def auth_header(cfg):
    user = cfg["wordpress"].get("user")
    app_password = cfg["wordpress"].get("app_password")
    if not user or not app_password:
        return None
    token = base64.b64encode(f"{user}:{app_password}".encode()).decode()
    return {"Authorization": f"Basic {token}"}


# ---------------------------------------------------------------------------
# Beitragsseite laden und Daten extrahieren
# ---------------------------------------------------------------------------

def fetch_page(url):
    headers = {"User-Agent": USER_AGENT}
    r = requests.get(url, headers=headers, timeout=20)
    r.raise_for_status()
    if r.encoding is None or r.encoding.lower() == "iso-8859-1":
        r.encoding = r.apparent_encoding or "utf-8"
    return r.text


def get_meta(soup, prop=None, name=None):
    if prop:
        tag = soup.find("meta", attrs={"property": prop})
    else:
        tag = soup.find("meta", attrs={"name": name})
    return tag["content"].strip() if tag and tag.get("content") else None


def find_content_container(soup):
    for sel in ["div.entry-content", "div.post-content", "article", "div#content", "main"]:
        el = soup.select_one(sel)
        if el:
            return el
    return soup.body or soup


def extract_title(soup):
    h1 = soup.find("h1")
    if h1 and h1.get_text(strip=True):
        return h1.get_text(strip=True)
    title = get_meta(soup, prop="og:title")
    if title:
        return title
    if soup.title:
        return soup.title.get_text(strip=True)
    return "TITEL_NICHT_GEFUNDEN"


def extract_date(soup):
    raw = get_meta(soup, prop="article:published_time")
    if raw:
        try:
            dt = datetime.fromisoformat(raw)
            return f"{dt.day}. {MONATE[dt.month - 1]} {dt.year}"
        except ValueError:
            pass
    return datetime.now().strftime("%d.%m.%Y")


def extract_teaser(soup, content):
    for p in content.find_all("p"):
        text = p.get_text(" ", strip=True)
        if len(text) > 60:
            return text
    desc = get_meta(soup, prop="og:description") or get_meta(soup, name="description")
    return desc or "TEASERTEXT_BITTE_MANUELL_EINFUEGEN"


def extract_caption_for_image(img):
    # Klassisches WordPress-Bildunterschrift-Markup: <div class="wp-caption">...<p class="wp-caption-text">
    wrapper = img.find_parent(["div", "figure"])
    if wrapper:
        cap = wrapper.find("figcaption") or wrapper.find(
            lambda tag: tag.name == "p" and tag.get("class") and
            any("caption" in c for c in tag.get("class"))
        )
        if cap:
            return cap.get_text(" ", strip=True)
    return ""


def extract_first_image(content, base_url):
    for img in content.find_all("img"):
        src = img.get("src") or img.get("data-src")
        if not src:
            continue
        if any(skip in src.lower() for skip in ("avatar", "logo", "header")):
            continue
        full_url = urljoin(base_url, src)
        alt = img.get("alt", "").strip()
        caption = extract_caption_for_image(img)
        return full_url, alt, caption
    return None, None, None


# ---------------------------------------------------------------------------
# Bild herunterladen und verkleinern
# ---------------------------------------------------------------------------

def slugify_stem(url):
    stem = Path(urlparse(url).path).stem
    stem = unicodedata.normalize("NFKD", stem).encode("ascii", "ignore").decode()
    stem = re.sub(r"[^A-Za-z0-9_\-]", "", stem)
    return stem or "bild"


def download_and_resize(image_url, output_dir):
    headers = {"User-Agent": USER_AGENT}
    r = requests.get(image_url, headers=headers, timeout=20)
    r.raise_for_status()

    tmp_path = output_dir / "_original_tmp"
    with open(tmp_path, "wb") as f:
        f.write(r.content)

    img = Image.open(tmp_path)
    if img.mode not in ("RGB", "L"):
        img = img.convert("RGB")
    ratio = THUMB_WIDTH / img.width
    new_size = (THUMB_WIDTH, max(1, round(img.height * ratio)))
    thumb = img.resize(new_size, Image.LANCZOS)

    stem = slugify_stem(image_url)
    out_name = f"{stem}{THUMB_WIDTH}px.jpg"
    out_path = output_dir / out_name
    thumb.save(out_path, "JPEG", quality=88)
    tmp_path.unlink(missing_ok=True)
    return out_path, new_size


# ---------------------------------------------------------------------------
# Automatischer Upload in die WordPress-Mediathek
# ---------------------------------------------------------------------------

def upload_to_wordpress(cfg, thumb_path, alt_text, site_url):
    headers_auth = auth_header(cfg)
    if not headers_auth:
        return None

    api_url = site_url.rstrip("/") + "/wp-json/wp/v2/media"
    headers = {
        **headers_auth,
        "Content-Disposition": f'attachment; filename="{thumb_path.name}"',
        "Content-Type": "image/jpeg",
    }
    with open(thumb_path, "rb") as f:
        data = f.read()

    try:
        r = requests.post(api_url, headers=headers, data=data, timeout=30)
    except requests.RequestException as e:
        print(f"Hinweis: Upload zu WordPress fehlgeschlagen ({e}).")
        return None

    if r.status_code not in (200, 201):
        print(f"Hinweis: Upload zu WordPress fehlgeschlagen ({r.status_code}): {r.text[:200]}")
        return None

    media = r.json()
    media_id = media.get("id")
    source_url = media.get("source_url")

    if alt_text:
        try:
            requests.post(
                f"{api_url}/{media_id}",
                headers=headers_auth,
                data={"alt_text": alt_text},
                timeout=15,
            )
        except requests.RequestException:
            pass

    return media_id, source_url


# ---------------------------------------------------------------------------
# Automatisches Einfügen des Tags auf der Startseite
# ---------------------------------------------------------------------------

def get_page_content(cfg, site_url, page_id):
    headers_auth = auth_header(cfg)
    if not headers_auth:
        return None, "Keine Zugangsdaten eingerichtet (siehe --setup)."

    api_url = f"{site_url.rstrip('/')}/wp-json/wp/v2/pages/{page_id}?context=edit"
    try:
        r = requests.get(api_url, headers=headers_auth, timeout=20)
    except requests.RequestException as e:
        return None, f"Seite konnte nicht geladen werden ({e})."
    if r.status_code != 200:
        return None, f"Seite konnte nicht geladen werden ({r.status_code}): {r.text[:200]}"

    data = r.json()
    raw_content = data.get("content", {}).get("raw")
    if raw_content is None:
        return None, "Rohinhalt der Seite nicht gefunden (evtl. fehlende Berechtigung)."
    return raw_content, None


def backup_page_content(content, page_id):
    BACKUP_DIR.mkdir(parents=True, exist_ok=True)
    stamp = datetime.now().strftime("%Y%m%d_%H%M%S")
    path = BACKUP_DIR / f"seite_{page_id}_{stamp}.html"
    path.write_text(content, encoding="utf-8")
    return path


def insert_tag_into_content(content, tag, post_url):
    if post_url in content:
        return None, "Dieser Beitrag ist schon auf der Seite verlinkt - nichts eingefügt (Duplikat vermieden)."

    marker_pos = content.find(FRONTPAGE_MARKER)
    if marker_pos == -1:
        return None, f"Text '{FRONTPAGE_MARKER}' wurde auf der Seite nicht gefunden."

    table_pos = content.find(TABLE_OPEN_TAG, marker_pos)
    if table_pos == -1:
        return None, f"Keine Tabelle ('{TABLE_OPEN_TAG}') nach dem Marker-Text gefunden."

    new_content = content[:table_pos] + tag.strip() + "\n" + content[table_pos:]
    return new_content, None


def update_page_content(cfg, site_url, page_id, new_content):
    headers_auth = auth_header(cfg)
    api_url = f"{site_url.rstrip('/')}/wp-json/wp/v2/pages/{page_id}"
    r = requests.post(api_url, headers=headers_auth, data={"content": new_content}, timeout=30)
    r.raise_for_status()
    return r.json()


# ---------------------------------------------------------------------------
# Tag zusammenbauen
# ---------------------------------------------------------------------------

def build_tag(url, title, date_str, teaser, thumb_url, thumb_size, alt_text, caption, attachment_id):
    width, height = thumb_size
    caption_text = caption or title
    return f'''<table {TABLE_STYLE}>
<tbody>
<tr>
<td {LEFT_CELL_STYLE}>

<a href="{url}"><img class="wp-image-{attachment_id} size-full" src="{thumb_url}" alt="{alt_text}" width="{width}" height="{height}" /></a> {caption_text}</td>
<td {RIGHT_CELL_STYLE}><a href="{url}"><strong>{title} - {date_str}:</strong></a> {teaser} - <a href="{url}">weiter</a> -.</td>
</tr>
</tbody>
</table>
'''


# ---------------------------------------------------------------------------
# Hauptprogramm
# ---------------------------------------------------------------------------

def main():
    parser = argparse.ArgumentParser(description="Erzeugt den WordPress-Vorschau-Tag für einen Blogbeitrag.")
    parser.add_argument("url", nargs="?", help="URL des Blogbeitrags")
    parser.add_argument("--setup", action="store_true", help="Zugangsdaten für Upload/Einfügen einrichten")
    parser.add_argument("--publish", action="store_true", help="Tag zusätzlich automatisch auf der Startseite einfügen")
    parser.add_argument("--page-id", type=int, default=DEFAULT_PAGE_ID, help=f"ID der Zielseite (Standard: {DEFAULT_PAGE_ID})")
    parser.add_argument("--yes", action="store_true", help="Bestätigung vor dem Veröffentlichen überspringen")
    args = parser.parse_args()

    if args.setup:
        setup_wizard()
        return

    url = args.url or input("URL des Beitrags eingeben: ").strip()
    if not url:
        print("Keine URL angegeben.")
        sys.exit(1)

    parsed = urlparse(url)
    site_url = f"{parsed.scheme}://{parsed.netloc}"

    OUTPUT_DIR.mkdir(exist_ok=True)
    cfg = load_config()

    print(f"Lade Beitrag: {url}")
    html = fetch_page(url)
    soup = BeautifulSoup(html, "html.parser")
    content = find_content_container(soup)

    title = extract_title(soup)
    date_str = extract_date(soup)
    teaser = extract_teaser(soup, content)
    image_url, alt_text, caption = extract_first_image(content, url)

    if not image_url:
        print("Kein Bild im Beitrag gefunden. Breche ab.")
        sys.exit(1)

    print(f"Titel:  {title}")
    print(f"Datum:  {date_str}")
    print(f"Bild:   {image_url}")

    print("Erzeuge Miniaturbild ...")
    thumb_path, thumb_size = download_and_resize(image_url, OUTPUT_DIR)
    print(f"Miniaturbild gespeichert unter: {thumb_path}  ({thumb_size[0]}x{thumb_size[1]} px)")

    upload_result = upload_to_wordpress(cfg, thumb_path, alt_text or title, site_url)
    have_credentials = auth_header(cfg) is not None
    if upload_result:
        attachment_id, thumb_url = upload_result
        print(f"Miniaturbild automatisch in die Mediathek hochgeladen (ID {attachment_id}).")
    else:
        attachment_id = PLATZHALTER_ID
        thumb_url = PLATZHALTER_URL
        print()
        print("Kein automatischer Upload eingerichtet oder er ist fehlgeschlagen (einmalig mit --setup möglich).")

    tag = build_tag(url, title, date_str, teaser, thumb_url, thumb_size, alt_text or title, caption, attachment_id)

    out_file = OUTPUT_DIR / f"tag_{slugify_stem(url)}.html"
    out_file.write_text(tag, encoding="utf-8")

    print()
    print("=" * 70)
    print(tag)
    print("=" * 70)
    print(f"Tag außerdem gespeichert unter: {out_file}")

    # -----------------------------------------------------------------
    # Automatisches Einfügen auf der Startseite
    # -----------------------------------------------------------------
    if not have_credentials:
        print("\nNoch zu erledigen:")
        print(f"  1. '{thumb_path.name}' von Hand in die Mediathek hochladen.")
        print(f"  2. Im Tag '{PLATZHALTER_URL}' durch die dortige Bild-URL ersetzen.")
        print(f"  3. Im Tag '{PLATZHALTER_ID}' (zweimal) durch die Attachment-ID ersetzen.")
        print(f"  4. Fertigen Tag von Hand in die Übersichtsseite einfügen.")
    elif attachment_id == PLATZHALTER_ID:
        print("\nBild-Upload ist fehlgeschlagen - automatisches Einfügen wird übersprungen.")
    else:
        print(f"\nLade aktuellen Inhalt von Seite {args.page_id} ...")
        page_content, err = get_page_content(cfg, site_url, args.page_id)
        if err:
            print(f"Automatisches Einfügen nicht möglich: {err}")
        else:
            backup_path = backup_page_content(page_content, args.page_id)
            print(f"Sicherungskopie der bisherigen Seite gespeichert unter: {backup_path}")

            new_content, err = insert_tag_into_content(page_content, tag, url)
            if err:
                print(f"Automatisches Einfügen nicht möglich: {err}")
            else:
                marker_pos = new_content.find(FRONTPAGE_MARKER)
                preview_start = max(0, marker_pos)
                preview = new_content[preview_start:preview_start + 400]
                print("\nVorschau der Stelle nach dem Einfügen:")
                print("-" * 70)
                print(preview)
                print("-" * 70)

                proceed = args.publish or args.yes
                if not proceed:
                    antwort = input(f"\nTag jetzt automatisch auf Seite {args.page_id} einfügen? [j/N]: ").strip().lower()
                    proceed = antwort in ("j", "ja", "y", "yes")

                if proceed:
                    try:
                        update_page_content(cfg, site_url, args.page_id, new_content)
                        print(f"Seite {args.page_id} wurde aktualisiert: {site_url}/")
                    except requests.RequestException as e:
                        print(f"Fehler beim Schreiben der Seite: {e}")
                        print(f"Die Sicherungskopie liegt weiterhin unter: {backup_path}")
                else:
                    print("Nicht eingefügt. Der Tag liegt weiterhin lokal zum manuellen Einfügen bereit.")


if __name__ == "__main__":
    main()
Fazit: Aus einem lästigen Handarbeitsschritt ist so, in drei kleinen Ausbaustufen, ein Programm geworden, das den kompletten Vorschau-Tag inklusive Bild von A bis Z selbst erledigt – vom Auslesen des Beitrags über das Erzeugen der Miniatur bis zum passenden Einbau auf der Startseite. Entstanden ist das Skript mit der kostenlosen Version von Claude.ai, und es soll hier nur als ein Beispiel dafür dienen, wie man sich mit ein bisschen Vibe-Coding das Leben leichter machen und sich lästige Routinetätigkeiten ersparen kann.